
OBKV-HBaseは、HBaseインターフェースと互換性のあるワイドテーブルデータベースです。大量の半構造化・構造化データの保存と、高速なデータアクセスに適しています。
OBKV-HBaseの主な強み
安定したP99
OBKV-HBaseはC++で開発され、独自のメモリ管理サブシステムを備えています。そのため、オープンソース版HBaseで発生するJavaのGCなど、メモリ管理に起因するレイテンシの変動を回避できます。OceanBaseが10年以上にわたりトランザクション処理で培ってきた技術を基盤に、ストレージへのアクセス経路を最適化し、P99レイテンシの安定性を高めています。
ホットレプリカ
OBKV-HBaseは、OceanBaseデータベースのネイティブな高信頼性機能に基づき、Paxosプロトコルによってマルチレプリカの強整合性を保証します。同時に、ノード障害が発生した場合でもホットレプリカへの迅速な切り替えを実現し、ビジネスアクセスの継続性を確保します。OceanBaseデータベースのバージョン4.0ではRTO<8sを実現可能です。オープンソースのHBaseはストレージと計算を分離したアーキテクチャを採用しており、RegionServer層の各パーティションには単一のレプリカしか存在しません。障害などの事象が発生すると、パーティションのスケジューリングや障害回復などのプロセスを経由するため、一般的にビジネスは数分間利用できなくなります。
クロスゾーンの災害復旧
OBKV-HBaseは、1つのクラスタインスタンスを複数のゾーンに展開することをサポートしており、よく言われる「2リージョン3データセンター」や「3リージョン5データセンター」といった災害復旧アーキテクチャを実装できるため、より高い災害復旧能力を備えています。オープンソースのHBaseは通常、Hlogを用いてプライマリ/スタンバイクラスタの災害復旧を行います。同一の災害復旧レベルで比較した場合、より多くのレプリカが必要となり、コストも高くなります。
高性能
OBKV-HBaseとオープンソースのHBaseはどちらもLSM-Treeベースのストレージエンジンを採用しており、書き込み性能において同様の利点を有しています。OceanBaseデータベースが10年以上にわたりTPシナリオで継続的に磨き上げてきた技術と最適化に支えられ、OBKV-HBaseは読み取りシナリオにおいても高い性能を発揮します。大規模データ量のシナリオでは、オープンソースのHBaseと比較して4倍以上の読み取り性能があります。
保守の容易さ
OBKV-HBaseは外部にOBServerのみを提供するため、分散実装におけるさまざまなロールの違いについて気にする必要はありません。OceanBaseデータベースは、開発・運用管理に使いやすい一連のツールを提供しており、運用のハードルを低くしています。また、OceanBaseデータベースはAll In Oneの統合データベースであるため、OBKVとOceanBaseデータベースの運用は完全に同一です。これにより、統一された企業の技術スタックを実現しつつ、複数のデータベースを運用する作業負担を軽減できます。
OBKV-HBaseの適用シナリオ
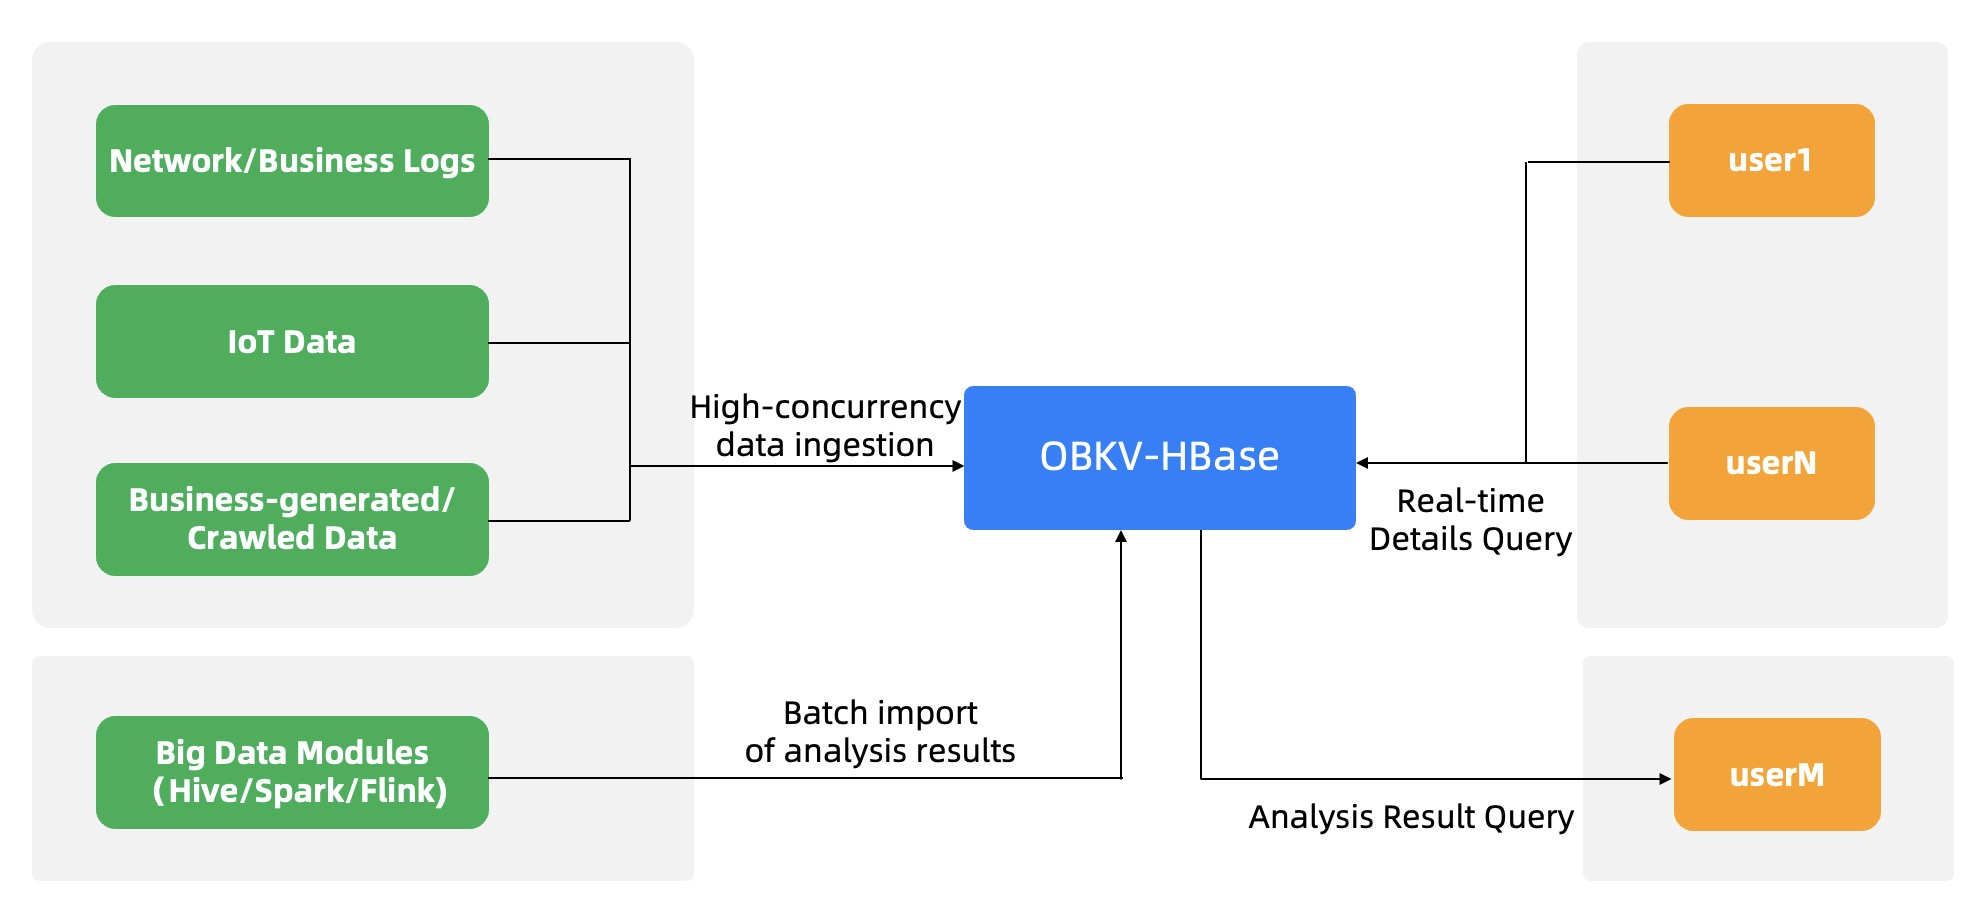
大量データストレージ
OBKV-HBaseは、OceanBaseデータベースの分散ストレージエンジンを基盤とし、リアルタイムの読み書きと、大量データの低コストストレージを提供します。インターフェースに基づく高速なバッチインポートやダイレクトロード機能を備えています。
OBKV-HBaseは、DataxやFlinkなどのオープンソースコンポーネントにも対応しており、増分データや全量データの効率的な同期を実現できます。Flinkやその他のデータウェアハウス・ビッグデータコンポーネントと連携して、データのリアルタイム/オフライン分析を行うことも可能です。もちろん、OceanBaseデータベースの統合機能を活用すれば、同一のデータに基づき、OceanBaseのリアルタイムデータウェアハウス機能を用いて単一のデータベース内でリアルタイム分析を行うこともできます。 アプリケーションログ、IoTデータ、軌跡データ、監視データなどの迅速かつリアルタイムなデータ取り込みに利用でき、その後、データウェアハウス/ビッグデータコンポーネントを活用してオンライン/オフライン分析を行います。
レコメンデーション/リスク管理などのシナリオにおける特徴データの高性能なリアルタイムアクセス
OBKV-HBaseは、OceanBaseデータベースが10年以上にわたり蓄積してきたTP能力に基づき、低遅延のデータ読み取りを提供します。水平スケーリング機能により、1,000万規模、あるいはそれ以上の同時アクセス能力を提供できます。
OBKV-HBaseはHBaseのSchemaless、ワイドテーブル、スパースカラム、マルチバージョン、TTLなどの特性をサポートしており、レコメンデーション/リスク管理などのシナリオにおいて、特徴データのストレージを柔軟に処理し、ビジネスが特徴データに対して求める高性能なアクセスを支えることができます。